AI Học Hỏi Từ Big Data (Dữ Liệu Lớn) Như Thế Nào? 6 Bước Quan Trọng

Trong kỷ nguyên số, Trí tuệ nhân tạo (AI) đã trở thành một lực lượng biến đổi mạnh mẽ, len lỏi vào mọi khía cạnh của đời sống, từ chăm sóc sức khỏe, tài chính, giáo dục đến thương mại điện tử và sản xuất. Sự tiến bộ vượt bậc của AI không chỉ tối ưu hóa quy trình mà còn mở ra những chân trời mới trong cách chúng ta làm việc và đưa ra quyết định.
Tại Sao Big Data Là “Nhiên Liệu” Cho Trí Tuệ Nhân Tạo?
Big Data cung cấp nền tảng để AI học hỏi, phân tích sâu rộng và đưa ra những dự đoán ngày càng chính xác.
Sức mạnh của AI không thể phát huy tối đa nếu thiếu đi “nguồn sống” là dữ liệu – đặc biệt là dữ liệu lớn. Bằng cách khai thác khối lượng dữ liệu khổng lồ và đa dạng từ vô số nguồn, AI có khả năng tự động hóa các tác vụ phức tạp, khám phá những xu hướng ẩn sâu và nâng cao khả năng ra quyết định theo thời gian thực.
>>>Tìm hiểu thêm: AI Và Big Data: Tại Sao Dữ Liệu Là “Xương Sống” Của AI
Vậy AI thực sự học hỏi từ dữ liệu lớn như thế nào? Hãy cùng Chief AI Officer khám phá 6 bước then chốt trong quá trình tiếp thu và phát triển kiến thức từ nguồn tài nguyên vô giá này.
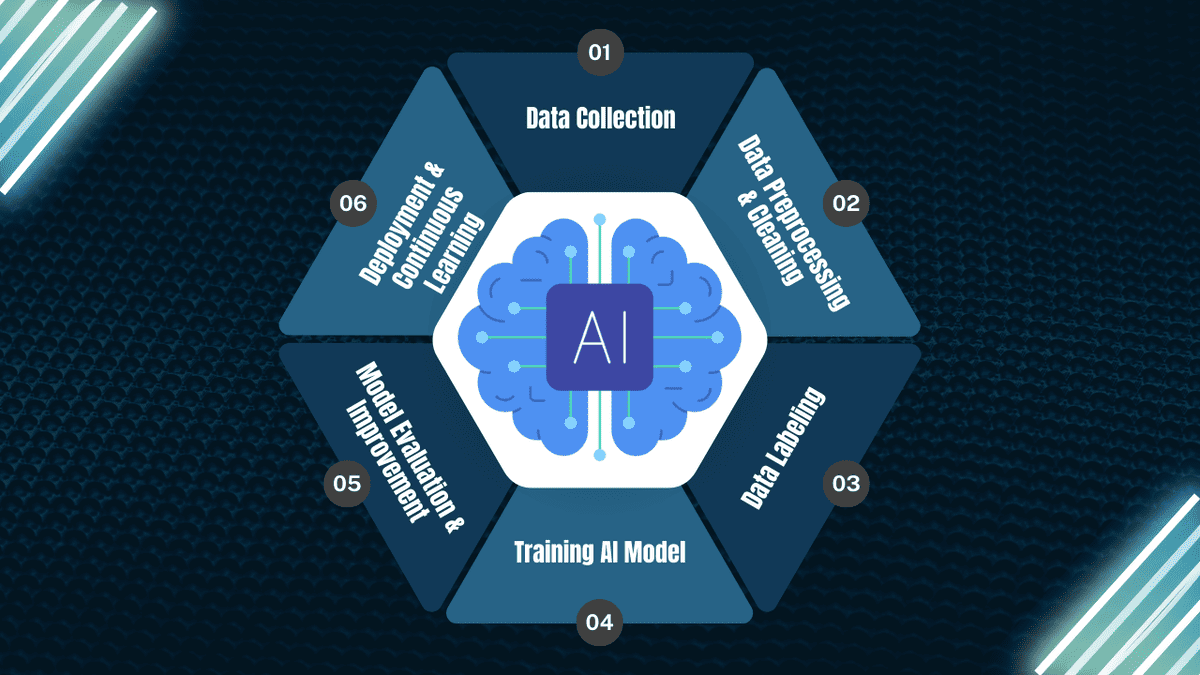
6 Bước AI Học Hỏi Và Phát Triển từ Big Data
Bước 1: Thu Thập Dữ Liệu Khổng Lồ (Data Collection)
Để có thể học hỏi và đưa ra những dự đoán chính xác, AI cần một lượng dữ liệu lớn và đa dạng. Quá trình đầu tiên là thu thập dữ liệu (Data Collection) từ nhiều nguồn khác nhau, sau đó tiến hành xử lý sơ bộ để chuẩn bị cho các bước tiếp theo. Các nguồn dữ liệu lớn có thể bao gồm mạng xã hội, thiết bị IoT, giao dịch tài chính, hồ sơ y tế, và nhiều hơn nữa.
Ví dụ: Facebook tận dụng thói quen tương tác của người dùng trên newfeed để phân tích sở thích cá nhân và hiển thị nội dung, quảng cáo phù hợp.
Bước 2: Xử Lý và Làm Sạch Dữ Liệu (Data Preprocessing & Cleaning)
Dữ liệu thô thường chứa nhiều tạp chất như lỗi, giá trị thiếu hoặc định dạng không đồng nhất, có thể dẫn đến những phân tích sai lệch. AI chủ động thực hiện các bước xử lý và làm sạch dữ liệu (Data Preprocessing & Cleaning) để đảm bảo chất lượng đầu vào. Quá trình này bao gồm:
- Loại bỏ dữ liệu nhiễu và trùng lặp: Phát hiện và loại bỏ các giá trị không liên quan hoặc bị trùng lặp.
- Chuẩn hóa dữ liệu: Đảm bảo tính nhất quán về định dạng (ví dụ: đơn vị đo lường, định dạng ngày tháng).
- Chuyển đổi dữ liệu: Biến đổi dữ liệu từ nhiều định dạng khác nhau (văn bản, hình ảnh, âm thanh…) sang dạng số mà AI có thể xử lý hiệu quả.
Bước 3: Gán Nhãn Dữ Liệu (Data Labeling) – Nền Tảng cho Học Có Giám Sát
Sau khi dữ liệu đã được làm sạch, bước tiếp theo là gán nhãn dữ liệu (Data Labeling), đặc biệt quan trọng đối với các mô hình Machine Learning có giám sát. Quá trình này bao gồm việc xác định và gắn các thông tin, thuộc tính có ý nghĩa vào dữ liệu, giúp AI hiểu được mối quan hệ giữa đầu vào và đầu ra. Việc trích xuất đặc trưng (feature extraction) và chuyển đổi dữ liệu sang định dạng phù hợp cũng diễn ra ở bước này, đảm bảo AI có thể học hỏi hiệu quả.
Ví dụ: Trong hệ thống nhận diện giọng nói (như Siri), AI phân tích các đặc trưng âm thanh như tần số, cao độ và chuyển đổi chúng thành dạng số hóa đã được gán nhãn tương ứng với các từ ngữ.

Bước 4: Huấn Luyện Mô Hình AI (Training AI Model) với Thuật Toán Thông Minh
AI sử dụng các thuật toán Machine Learning hoặc Deep Learning để học hỏi từ dữ liệu đã được chuẩn bị. Quá trình huấn luyện mô hình AI (Training AI Model) bao gồm:
- Học có giám sát (Supervised Learning): AI học từ dữ liệu đã được gán nhãn, tìm ra mối quan hệ giữa đầu vào và nhãn để dự đoán kết quả cho dữ liệu mới.
- Học không giám sát (Unsupervised Learning): AI tự động tìm kiếm các cấu trúc, quy luật ẩn trong dữ liệu chưa được phân loại.
- Học tăng cường (Reinforcement Learning): AI học thông qua tương tác với môi trường, nhận phần thưởng hoặc hình phạt dựa trên hành động của mình để tối ưu hóa chiến lược.
Ví dụ: Hệ thống gợi ý phim của Netflix sử dụng học không giám sát để phân nhóm người dùng có sở thích xem phim tương đồng, từ đó đưa ra các đề xuất phù hợp.
Bước 5: Đánh Giá và Tối Ưu Hóa Mô Hình AI (Model Evaluation & Improvement)
Sau quá trình huấn luyện, mô hình AI cần được đánh giá và tối ưu hóa (Model Evaluation & Improvement) để đảm bảo hiệu suất cao nhất trên dữ liệu thực tế. Mô hình sẽ được kiểm tra trên một tập dữ liệu mới (chưa từng được sử dụng trong quá trình huấn luyện) để đánh giá độ chính xác, phát hiện các lỗi tiềm ẩn và điều chỉnh thuật toán nếu cần thiết. Nếu kết quả chưa đạt yêu cầu, việc bổ sung thêm dữ liệu hoặc tinh chỉnh các tham số của mô hình có thể giúp cải thiện khả năng học và đưa ra dự đoán chính xác hơn.
Bước 6: Triển Khai Thực Tế và Cập Nhật Liên Tục (Real-world Deployment & Continuous Learning)
Khi mô hình AI đạt được hiệu suất mong muốn, nó sẽ được triển khai vào thực tế (Real-world Deployment) để giải quyết các vấn đề cụ thể. Tuy nhiên, quá trình học hỏi của AI không dừng lại ở đó. Các hệ thống AI hiện đại thường được thiết kế để cập nhật liên tục (Continuous Learning), tự động tiếp nhận và học hỏi từ dữ liệu mới, từ đó cải thiện độ chính xác và khả năng thích ứng với những thay đổi của môi trường. Một số hệ thống còn có khả năng tự động điều chỉnh (AI Adaptation) để bắt kịp các xu hướng mới.
Kết Luận
Để khai thác và phát triển sức mạnh của AI từ dữ liệu lớn cũng đặt ra những thách thức không nhỏ. Việc quản lý, bảo mật và đảm bảo chất lượng của dữ liệu lớn đòi hỏi các giải pháp công nghệ tiên tiến, quy trình quản lý chặt chẽ và đội ngũ nhân sự có chuyên môn cao. Bên cạnh đó, vấn đề về quyền riêng tư, đạo đức AI và tính minh bạch trong các quyết định của AI cũng cần được các nhà lãnh đạo quan tâm và giải quyết một cách có trách nhiệm.
Quá trình AI học hỏi từ dữ liệu lớn là một hành trình không ngừng nghỉ, đòi hỏi sự đầu tư liên tục vào công nghệ, con người và quy trình. Với sự hỗ trợ mạnh mẽ từ dữ liệu lớn, AI đang ngày càng trở thành một công cụ không thể thiếu, không chỉ tối ưu hóa các hoạt động hiện tại mà còn mở đường cho những đổi mới mang tính cách mạng trong tương lai.
Các doanh nghiệp và nhà lãnh đạo nhận thức rõ ràng về sức mạnh và quy trình học hỏi này sẽ có lợi thế to lớn trong việc định hình tương lai của ngành mình và vươn lên dẫn đầu trong kỷ nguyên số đầy cạnh tranh. Việc khai thác hiệu quả dữ liệu lớn thông qua AI không chỉ là một xu hướng mà là một yêu cầu then chốt cho sự phát triển bền vững trong tương lai.
Bạn Đã Sẵn Sàng Làm Chủ AI Và Dẫn Dắt Doanh Nghiệp?
Khóa học Thạc sĩ Khoa học về Trí tuệ Nhân tạo (MSc in AI) do Viện IDEAS phối hợp cùng Đại học UMEF Thụy Sĩ mang đến chương trình đào tạo bài bản, cập nhật những xu hướng AI mới nhất. Với đội ngũ giảng viên là các chuyên gia hàng đầu trong lĩnh vực, bạn sẽ được trang bị đầy đủ kiến thức và kỹ năng để tự tin ứng dụng AI vào giải quyết các bài toán thực tế của doanh nghiệp. Liên hệ hotline: 028 2442 244 để được hỗ trợ tư vấn chi tiết.





Phản hồi